
検証ノート
ChatGPT・Claude・Gemini の違いと使い分け。同じお題で45回討論させて見えた、3体の「性格」
結論:同じ価格帯でそろえた各社の最新世代のモデル(GPT-6.1 Sol・Claude Sonnet 5.5・Gemini 4 Argon。各社の中での位置づけは異なる)に、同じお題で 45 回討論させ、書き方・批評・まとめ方を数えると、はっきりした「くせ」が見えました。GPT は決められた字数に収め、批評では事実の誤りを指摘する書式を使うことが多い。Claude は批評で箇条書きを多く使い、まとめ役になると GPT と違ってどの AI の意見かを書き残す。Gemini は言い切る書き方で長く書き、まとめでは採否の理由などの補足メモを厚く残す。どれが優れているかではなく、くせを知って使い分けるための記事です。
ここで言う「性格」は、この記事の条件(2026 年 10 月の版、日本語の制度・技術の解説、ウェブ検索なし)で観察した、書き方・批評・まとめ方の傾向のことです。モデルの一般的な優劣や、人の性格のようなものを決めつけるものではありません。正確さ(誤りの少なさ)の比較は、別の記事「ChatGPT・Claude・Gemini の正確性を比較」にまとめています。
目次
なぜ、3 つの AI の「くせ」を数えたのか。
ChatGPT・Claude・Gemini を使い分けたい人は多いはずです。ところが、違いを説明する記事の多くは、料金・機能・得意分野の表か、数問を試した印象にとどまっています。
DebateCross は、3 社の AI に同じお題を渡して討論させるサービスです。各 AI が独立に答え(Round 1)、互いの答えを批評し(Round 2)、1 体がまとめる(Round 3)。料金の単価がそろった各社の最新モデル、GPT-6.1 Sol・Claude Sonnet 5.5・Gemini 4 Argon の 3 体で、この 3 ラウンドを同じ 15 テーマで 3 回ずつ、計 45 回行いました。同じお題・同じ指示で 3 体を並べた文章が 135 本、批評が 135 本、まとめが 45 本です。
これだけの記録を同じ条件で並べると、印象ではなく数字で、3 体の書き方の違いが見えてきます。そこで、文章の長さ・指示の守り方・批評で何を指摘したか・まとめ方などを、決めた規則で数えました。
DebateCross は、どの AI 会社とも提携・広告の関係はありません。ただし「複数の AI を組み合わせる」ことを勧める立場の運営が書いた記事です。
3 体のプロフィール。
| GPT(GPT-6.1 Sol) | Claude(Claude Sonnet 5.5) | Gemini(Gemini 4 Argon) | |
|---|---|---|---|
| ひとことで | 字数を守り、誤りを指摘する | 箇条書きで多く挙げ、誰の意見かも書く | 言い切って長く書き、補足メモを厚く残す |
| 書き手として | 指定字数に 98% 収めた | 指定字数を超えやすい(収めたのは 27%) | 留保の言い回しが少ない(他の 2 体の 3〜4 割)。最も長く書く(約 1,600 字) |
| 批評者として | 事実の誤りを指摘する書式を使った数が最多(1 本あたり 1.56) | 箇条書きの行が最も多い(1 本あたり約 60 行) | 誤りを指摘する書式の使用は少ない(0.22)。どれがいちばんよいか決めきれないと「同等」とする(16%) |
| まとめ役として | 最終回答の本文も指定字数に収める(93%)。誰の意見かは書かない(0%) | どの AI の意見かを補足メモに名前で書く(67%。Gemini は 40%) | 補足メモが最も厚い(最終回答の 45%) |
| 気をつける点 | 「どの回答がいちばんよいか」では、ほぼ必ず自分の回答を選ぶ(93%) | 指定字数を超えやすい(収めたのは 27%)。批評で相手を「回答1」のように位置だけで呼び、誰への指摘か分かりにくいことがある | 指定字数をほとんど守らない(収めたのは 2%)。留保が少ないぶん、確かめるべき点が文面から見えにくい |
(2026 年 10 月 15 日の討論、15 テーマ × 各 3 回。「補足メモ」は、まとめ役が最終回答の末尾に付ける、採否の理由や合意点の説明。数値の定義と区間は後半)
書き手としてのくせ。
3 体に同じお題を渡し、「800〜1,200 字で解説してください」と同じ指示で書かせた Round 1 の 135 本を比べました。
| GPT | Claude | Gemini | |
|---|---|---|---|
| 平均の長さ | 1,058 字 | 1,274 字 | 1,603 字 |
| 指定字数に収めた割合 | 98% | 27% | 2% |
| 数字の書き込み(千字あたり) | 14.7 | 16.8 | 12.3 |
| 「確認が必要」「可能性があります」などの言い回し(千字あたり) | 0.55 | 0.69 | 0.22 |
(数字の書き込みは、3 体の差が小さく、区間が重なります)
GPT(GPT-6.1 Sol)
指示された字数をほぼ守ります。45 本中 44 本を 800〜1,200 字に収め、平均 1,058 字と 3 体でいちばん短く書きました。
Claude(Claude Sonnet 5.5)
指定字数を超えることが多く、収めたのは 45 本中 12 本でした。平均 1,274 字で、GPT より 2 割ほど長めです。
Gemini(Gemini 4 Argon)
3 体でいちばん長く書き(平均 1,603 字)、指定字数に収めたのは 45 本中 1 本だけでした。「〜の可能性があります」のような留保をあまり使わず(他の 2 体の 3〜4 割)、言い切る書き方です。言い切っているから確かだ、とは限りません(正確さは別記事)。
批評者としてのくせ。
Round 2 では、各 AI が自分の分を含む 3 体の答えを読み(どれが自分の答えかは知らされています)、良い点・疑問点・見落としなどを書きます。DebateCross の批評の指示では、他の AI の明確な事実の誤りを指摘するときに「🔍 クロスチェック」という決まった書式を使います。批評 135 本を比べました。
| GPT | Claude | Gemini | |
|---|---|---|---|
| 誤りを指摘する書式(🔍 クロスチェック)の数/本 | 1.56 | 1.07 | 0.22 |
| 箇条書きの行の数/本 | 約 21 | 約 60 | 約 29 |
| 最終評価で自分の回答を選んだ回数 | 42/45 | 14/45 | 2/45 |
| 最終評価で「同等」とした回数 | 0/45 | 1/45 | 7/45 |
GPT(GPT-6.1 Sol)
見出しを多く立てて段落で書き、誤りを指摘する書式を 1 本あたり 1.56 回と最も多く使いました(指摘が正しかったかは数えていません)。最後の「どの回答がいちばんよいか」では、45 回中 42 回、自分の回答を選んでいます。
Claude(Claude Sonnet 5.5)
箇条書きで多く挙げます(1 本あたり約 60 行)。誤りを指摘する書式も 1.07 回と GPT に次いで多めでした。一方、相手の回答を「回答1」のように位置だけで呼ぶことが多く(45 本で 225 件)、誰への指摘かが分かりにくい批評もありました。自分の回答を選んだのは 45 回中 14 回です。
Gemini(Gemini 4 Argon)
誤りを指摘する書式を使うことは少なく(0.22 回)、留保の言い回しも 3 体でいちばん少ない批評でした。「どれがいちばんよいか」では、45 回中 7 回、選ばずに「同等」と書いています。自分の回答を選んだのは 45 回中 2 回でした。
まとめ役としてのくせ。
Round 3 では、1 体がまとめ役(統合役)になり、3 体の答えと批評を踏まえて最終回答を書きます。統合役は回ごとに入れ替えたので、3 体とも 15 回ずつまとめ役を務めています。最終回答 45 本を比べました。
| GPT | Claude | Gemini | |
|---|---|---|---|
| 最終回答の長さ(末尾の補足メモ込み) | 1,358 字 | 2,254 字 | 2,625 字 |
| 本文(補足メモを除く)を指定字数に収めた割合 | 93% | 7% | 0% |
| 補足メモが全体に占める割合 | 18% | 33% | 45% |
| 補足メモで、どの AI の意見かを名前で書いた割合 | 0% | 67% | 40% |
| 他の 2 体だけが書いた数字を取り込んだ割合 | 14% | 46% | 44% |
GPT(GPT-6.1 Sol)
まとめ役でも本文を指定字数に収め(93%)、補足メモは短め(最終回答の 18%)です。どの意見を誰から採ったかは書かず、1 本の文章に仕上げます。
Claude(Claude Sonnet 5.5)
補足メモを含めて平均約 2,250 字でまとめ、どの意見を誰から採ったかを補足メモに名前で書くことが多くありました(67%。Gemini の 40% との差ははっきりしません)。他の AI が書いた数字の取り込みは 46% でした(GPT の 14% とは区間が一部重なります)。
Gemini(Gemini 4 Argon)
平均約 2,600 字と最も長くまとめ、採否の理由などの補足メモが最終回答のほぼ半分(45%)を占めました。他の AI が書いた数字の取り込みは 44% でした。
どう使い分けるか。
この記事の条件で見えたくせから、使い分けを考えると次のようになります。どれが優れているかではなく、目的に合うくせを選ぶ、という考え方です。
| こんなとき | 合いそうな AI | 理由(今回のくせ) | 気をつける点 |
|---|---|---|---|
| 字数や形式の決まった文章を書かせたい | GPT | 指定字数に 98% 収めた | 文章は 3 体でいちばん短い(約 1,060 字) |
| 他の AI の答えの誤りの候補を多く挙げてほしい | GPT | 誤りを指摘する書式を使った数が最多 | 指摘の正しさは別に確かめる。最後の評価では、ほぼ必ず自分の回答を選ぶ |
| 指摘を箇条書きで多く挙げ、誰の意見かを残してまとめたい | Claude | 箇条書きの行が最も多く、補足メモに誰の意見かを 67% で書いた | 指定字数を超えやすい。相手を位置だけで呼び、誰への指摘か分かりにくいことがある |
| 留保の少ない言い切る文面と、採否の理由の厚いメモがほしい | Gemini | 留保が少なく、補足メモが最も厚い | 字数はほとんど守らない。確かめるべき点が文面から見えにくい。誤りを指摘する書式の使用は少ない |
(表の Gemini は Gemini 4 Argon。どの AI でも、事実は最後に一次情報で確かめてください)
1 つの AI のくせに頼るより、くせの違う AI どうしに批評させると、互いの弱点を補えます(AIのハルシネーション対策を測った)。
詳しい数値と方法。
ここからは、数え方と区間、テーマによるばらつき、別の組み合わせの討論でも同じだったか、判定役としてのくせ、この結果の限界を詳しく書きます。
元にした記録
| 項目 | 内容 |
|---|---|
| 討論 | 45 回(15 テーマ × 各 3 回、2026 年 10 月 15 日)。記事「ChatGPT・Claude・Gemini の正確性を比較」で Gemini 4 Argon の文章に使ったのと同じ討論の記録 |
| モデル | GPT-6.1 Sol/Claude Sonnet 5.5/Gemini 4 Argon(OpenRouter の API で利用。単価はどれも入力 $2・出力 $10/100 万トークン、2026 年 10 月 14 日確認) |
| お題 | 「〜について 800〜1,200 字で解説してください」の形の、日本語の制度・技術の解説 15 テーマ(法制度・税 9、技術 2、統計 1、存在しない制度や規格を尋ねるもの 3) |
| 条件 | ウェブ検索なし・添付なし。3 体に同じお題・同じ指示 |
| 統合役 | 1 回ごとに入れ替え(各テーマの 1 回目 Claude、2 回目 GPT、3 回目 Gemini。各 15 回) |
| 数えた文章 | Round 1 の回答 135 本、Round 2 の批評 135 本、Round 3 の最終回答 45 本 |
単価をそろえたため、各社の中での位置づけは異なります(Gemini 4 Argon は Gemini の最上位、GPT-6.1 Sol は GPT-6.1 の中間、Claude Sonnet 5.5 は Claude の標準)。GPT は、使うモデルを決めた時点(2026 年 10 月 8 日。GPT-6.1 Sol 版の討論の日)では GPT-6 の世代に Terra が無かったため、GPT-6.1 の中間の Sol を使っています。その後、2026 年 10 月 27 日に GPT-6.1 Terra(単価は Sol の半額)が提供されました。
この記事の初版の下書きは、記事「AIのハルシネーション対策を測った」の 45 討論(GPT-6.1 Sol Pro・Gemini 3.8 Flash を含む組み合わせ、10 月 3〜4 日)を主役にしていました。記事「正確性を比較」を同じ価格帯の最新 3 モデルで組み直したのに合わせ、公開前に主役をこの討論に替えています。元の記録でも多くのくせが同じ向きだったことは、後述の「別の組み合わせの討論でも同じか」に載せています。
数え方
長さ・字数・語の数・クロスチェックの数などは、AI に判定させず、本文の文字列を決めた規則で数えました(数え方のプログラムと正規表現、数えた批評文は検証データ一式に載せています)。区間は、テーマ単位のクラスター・ブートストラップ(15 テーマを復元抽出、10,000 回)による 95% 区間です。2 体の差の区間は、同じお題の文章をまとめて復元抽出して出しました。
| 指標 | 数え方 |
|---|---|
| 指定字数に収めた割合 | 本文の文字数(Markdown の記号を含む)が 800〜1,200 字だった割合。まとめ役は、末尾の「統合メモ」を除いた本文で判定 |
| 数字の書き込み | 数字+単位(%・年・円・条 など)の数 ÷ 字数 × 1,000 |
| 留保の言い回し | 「確認が必要」「確認してください」「可能性があります」「と考えられ」「場合があります」「とされています」「一般的に」「注意が必要」の数 ÷ 字数 × 1,000(批評の表の値は、「かもしれない」「判断できない」などを加えた別の一覧で数えたもの) |
| クロスチェック | 批評の指示で「他の AI の回答に明確な事実誤認や古いデータがある場合のみ使う」「1 回の批評につき最大 1〜2 件」と決めた書式(🔍 クロスチェック)の数。形式が決まっているので数え漏れが少ない。指摘が正しかったかは数えていない |
| 自分の回答を選んだ割合・「同等」とした割合 | 批評の最後の「最終評価」で、最も良いとした回答が批評者自身のものだった割合と、「同等」と書いた割合(指示は「最も優れていると思う回答を 1 つ選び、選びきれない場合は『同等』と明記」。批評者は、どれが自分の回答かを知らされている) |
| 自分の回答であることに触れた割合 | 「私自身」「自分の回答」「自身の回答」「自己評価に甘く」などの語がある批評の割合。そのうち「断りの言葉を伴う割合」は、その語の前後 80 字に「甘く」「厳しめ」「厳しく」「バイアス」「公平」などがある批評の割合(この語の一覧は、Gemini 4 Argon の記録を見たあとの 2026 年 10 月 15 日に足したもの。Argon が見出しで「(自身の回答)」と書くだけのラベルを、断り書きと区別するため) |
| 他の 2 体だけが書いた数字を取り込んだ割合 | まとめ役自身の Round 1 になく、他の 2 体の Round 1 にあった数字+単位のうち、最終回答の本文に同じ形で出た割合 |
| 統合メモ(補足メモ) | 最終回答の末尾で、合意点・少数意見・採用基準などを説明する部分(指示で求めている)。「どの AI の意見かを名前で書いた割合」は、統合メモにモデル名が 1 回以上出た割合 |
書き手として(Round 1、各 45 本)
| 指標 | GPT-6.1 Sol | Claude Sonnet 5.5 | Gemini 4 Argon |
|---|---|---|---|
| 平均の長さ | 1,058 字[1,034, 1,085] | 1,274 字[1,192, 1,351] | 1,603 字[1,446, 1,734] |
| 指定字数に収めた割合 | 98%(44/45)[93, 100] | 27%(12/45)[11, 44] | 2%(1/45)[0, 7] |
| 数字の書き込み(千字あたり) | 14.7[9.2, 20.6] | 16.8[11.2, 22.7] | 12.3[7.7, 17.0] |
| 留保の言い回し(千字あたり) | 0.55[0.30, 0.82] | 0.69[0.47, 0.92] | 0.22[0.09, 0.36] |
留保の言い回しの差は、同じお題どうしで比べて GPT − Gemini が +0.33(95% 区間 +0.07〜+0.61)、Claude − Gemini が +0.47(+0.29〜+0.66)で、Gemini の少なさははっきりしていました。数字の書き込みは、区間が大きく重なるため、くせとしては扱っていません。主張(1 文 1 事実)の数は、この討論では Gemini の分だけを分解しています(1 本あたり 33.5。他のモデルの値は記事「正確性を比較」)。
批評者として(Round 2、各 45 本)
| 指標 | GPT-6.1 Sol | Claude Sonnet 5.5 | Gemini 4 Argon |
|---|---|---|---|
| クロスチェックの数/本 | 1.56[1.20, 1.84] | 1.07[0.76, 1.36] | 0.22[0.04, 0.44] |
| クロスチェックを 1 つ以上書いた割合 | 87%[67, 100] | 73%[56, 89] | 18%[4, 36] |
| 最終評価で自分の回答を選んだ割合 | 93%[82, 100] | 31%[16, 47] | 4%[0, 11] |
| 最終評価で「同等」とした割合 | 0%[0, 0] | 2%[0, 7] | 16%[4, 29] |
| 自分の回答であることに触れた割合 | 2%[0, 7] | 60%[47, 73] | 62%[51, 73] |
| 断りの言葉を伴う批評の割合(全体のうち。事後の指標) | 2%(1/45) | 36%(16/45) | 4%(2/45) |
| 相手をモデル名ではなく「回答1」のような位置だけで呼んだ数(45 本の合計) | 2 | 225 | 0 |
| 批評文の長さ | 4,307 字[4,157, 4,460] | 4,802 字[4,554, 5,037] | 3,999 字[3,822, 4,185] |
| 見出しの行の数(平均。区間なし) | 24.4 | 11.2 | 6.0 |
| 箇条書きの行の数 | 21.1[17.8, 24.8] | 60.1[54.0, 66.6] | 29.1[25.5, 33.0] |
| 留保の言い回し(千字あたり) | 0.5[0.3, 0.6] | 0.9[0.6, 1.1] | 0.1[0.0, 0.3] |
クロスチェックの数の差は、同じお題どうしで比べて GPT − Claude が +0.49(95% 区間 +0.24〜+0.73)、Claude − Gemini が +0.84(+0.60〜+1.09)でした。
クロスチェックの向き先にも違いがありました。GPT の 70 件は、Claude 宛てが 39 件、Gemini 宛てが 21 件(残りは宛先を判別できず)。Claude の 48 件は、Gemini 宛てが 26 件、GPT 宛てが 4 件で、18 件は宛先を判別できませんでした。Gemini は 10 件と少なく、Claude 宛て 6 件、GPT 宛て 4 件でした。指摘が正しかったかどうかは、この記事では数えていません(正確さは「ChatGPT・Claude・Gemini の正確性を比較」)。
最終評価で選んだ相手は、Claude が GPT を 26 回、Gemini が GPT を 25 回・Claude を 11 回でした。選ばれた回数はモデルの優劣を示すものではないため、この記事では「自分を選ぶかどうか」と「同等とするか」だけを使っています。
「自分の回答であることに触れた割合」は、Claude と Gemini が同じくらいですが、中身が違います。記録を見たあとに足した事後の指標で数えると、Claude は「自己評価に甘くならないよう、他の回答と同じ厳しさで見ます」のように断る批評が 36% あったのに対し、Gemini は見出しに「(自身の回答)」と書き添えるラベルがほとんどで、断る批評は 4% でした。
Gemini 4 Argon は観点の見出しを付けない書き方が多く(見出しの行は 1 本あたり 6.0)、「妥当な点」と「疑問点」の節の分量は、両方を拾えたのが 45 本中 15 本だけだったため、比べていません。
まとめ役として(Round 3、各 15 本)
| 指標 | GPT-6.1 Sol | Claude Sonnet 5.5 | Gemini 4 Argon |
|---|---|---|---|
| 最終回答の長さ(統合メモ込み) | 1,358 字[1,305, 1,411] | 2,254 字[2,144, 2,362] | 2,625 字[2,513, 2,754] |
| 本文の長さ(統合メモを除く) | 1,104 字[1,065, 1,146] | 1,500 字[1,386, 1,633] | 1,428 字[1,349, 1,527] |
| 本文を指定字数に収めた割合 | 93%[80, 100] | 7%[0, 20] | 0%[0, 0] |
| 本文 ÷ 自分の Round 1 の長さ | 1.04[1.00, 1.07] | 1.17[1.06, 1.29] | 0.99[0.83, 1.27] |
| 他の 2 体だけが書いた数字を取り込んだ割合 | 14%[7, 23] | 46%[20, 58] | 44%[31, 63] |
| 他の 2 体だけが書いた語(英字・カタカナ・「」)を取り込んだ割合 | 8%[3, 11] | 15%[9, 23] | 38%[31, 49] |
| 統合メモの長さ | 248 字[233, 262] | 747 字[663, 829] | 1,190 字[1,136, 1,242] |
| 統合メモが全体に占める割合 | 18%[18, 19] | 33%[29, 37] | 45%[44, 47] |
| 統合メモで、どの AI の意見かを名前で書いた割合 | 0%[0, 0] | 67%[40, 87] | 40%[13, 67] |
| 統合メモのモデル名のうち、自分を指した割合 | — | 28%[23, 34] | 23%[14, 31] |
| 本文の箇条書きの行の数 | 3.6[2.7, 4.5] | 12.7[10.4, 14.7] | 7.5[5.4, 9.9] |
まとめ役は討論ごとに 1 体です。3 体とも同じ 15 テーマを 1 回ずつまとめていますが、まとめたのは同じテーマの別の回の討論なので、入力された回答・批評の偶然の違いも差に入ります。GPT は、まとめ役でも本文をほぼ自分の Round 1 と同じ長さにし、統合メモも短く、モデル名を 1 度も出しませんでした。Gemini は、統合メモが平均約 1,200 字と、本文とほぼ同じ厚さでした。他の 2 体だけが使った語(用語や「」で囲んだ言い回し)を最終回答に取り込む割合も、Gemini が最も高めでした。
テーマによるばらつき
くせの強さは、テーマによって変わりました。くせが最もはっきりしていたのは、GPT の字数の守り方です。書き手としては 45 本中 44 本を指定字数に収め、批評の長さのテーマ間のばらつき(標準偏差 312 字)も 3 体でいちばん小さめでした。一方、Claude の「自分の回答であることに触れる」は、テーマによって 0%〜100% と幅がありました。クロスチェックの数も、テーマごとの平均で GPT 0〜2.0、Claude 0〜2.0、Gemini 0〜1.3 と幅がありました。数件の差で順位が入れ替わる指標は、前半の表に載せていません。
別の組み合わせの討論でも同じか(参考)
同じ 15 テーマ × 各 3 回の討論を、参加モデルを替えてあと 2 回行っています。記事「AIのハルシネーション対策を測った」の討論(10 月 3〜4 日。GPT-6.1 Sol Pro・Claude Sonnet 5.5・Gemini 3.8 Flash)と、GPT-6.1 Sol 版(10 月 8 日。GPT-6.1 Sol・Claude Sonnet 5.5・Gemini 3.8 Flash)です。Gemini 3.8 Flash は Argon より単価が低い(約 4 割)モデル、GPT-6.1 Sol Pro は Sol を推論を多く使う pro モードで動かしたものです。
| 指標 | 本文(10/15。Sol・Sonnet・Argon) | 「AIのハルシネーション対策を測った」の討論(10/3〜4。Sol Pro・Sonnet・Flash) | Sol 版(10/8。Sol・Sonnet・Flash) |
|---|---|---|---|
| GPT:指定字数に収めた割合(書き手) | 98% | 96% | 100% |
| GPT:クロスチェックの数/本 | 1.56 | 1.58 | 1.40 |
| GPT:最終評価で自分の回答を選んだ割合 | 93% | 98% | 93% |
| Claude:批評の箇条書きの行の数 | 60.1 | 62.6 | 62.7 |
| Claude:断りの言葉を伴う批評の割合(事後の指標) | 36% | 40% | 47% |
| Claude:統合メモで、どの AI の意見かを名前で書いた割合 | 67% | 80% | 53% |
| Gemini:留保の言い回し(書き手、千字あたり) | 0.22(Argon) | 0.21(Flash) | 0.23(Flash) |
| Gemini:クロスチェックの数/本 | 0.22(Argon) | 0.22(Flash) | 0.22(Flash) |
| Gemini:統合メモが全体に占める割合 | 45%(Argon) | 35%(Flash) | 37%(Flash) |
| Gemini:最終評価で「同等」とした割合 | 16%(Argon) | 0%(Flash) | 0%(Flash) |
| Gemini:書き手としての平均の長さ(Claude) | 1,603 字(Argon。Claude 1,274 字) | 1,349 字(Flash。Claude 1,296 字) | 1,377 字(Flash。Claude 1,320 字) |
(同じモデルでも、討論の相手が変わると値は少し動きます)
GPT・Claude のくせと、Gemini の「留保の少なさ」「クロスチェックの少なさ」「統合メモの厚さ」は、3 つの記録のどれでも同じ向きでした。Gemini が 3 体で最も長く書くのも 3 つの記録で同じでしたが、Argon では Claude との差がはっきりしていたのに対し、Flash では区間が重なる程度の差でした。Gemini 4 Argon だけに見えたくせは、最終評価で「同等」とすること(16%)で、Gemini 3.8 Flash にはありませんでした。逆に、3.8 Flash の批評では「妥当な点」の節が「疑問点」の節より厚く(「AIのハルシネーション対策を測った」の討論で 24% と 16%、Sol 版で 24% と 13%)、良い点を厚く書く傾向がありましたが、Argon では見出しの付け方が違うため比べられていません。
GPT-6.1 Terra 版の討論(参考)
Terra 版の参考集計では、Terra の批評文は平均 2,287 字、クロスチェックを含む批評は 84% でした。ただし完了 43 討論に限る集計で、統合役も Claude 29 本・Terra 14 本と他の版とは異なります。
| 指標 | Claude Sonnet 5.5 | GPT-6.1 Terra | Gemini 4 Argon |
|---|---|---|---|
| 批評文の長さ(各 43 本) | 4,565 字[4,282, 4,858] | 2,287 字[2,203, 2,373] | 4,016 字[3,791, 4,231] |
| クロスチェックを 1 つ以上書いた割合 | 72%[51, 90] | 84%[67, 98] | 14%[0, 29] |
| 最終評価で自分の回答を選んだ割合 | 12%[4, 21] | 63%[43, 81] | 21%[7, 37] |
| Round 3 の本文の長さ(統合メモを除く) | 1,506 字[1,406, 1,623](29 本) | 946 字[893, 1,005](14 本) | —(統合役 0 本) |
値は点推定[テーマ単位の 95% 区間]です。入力 45 討論のうち、s1 t13・s3 t01 は Round 2 で失敗し Round 3 も欠けるため、両ラウンドの集計から除いています。統合役は s1・s2 が Claude、s3 が Terra で、事前登録から s2・s3 がずれましたが再実行していません。実行順は s2 → s3 → s1(s1 は回し直し)でした。統合役ごとの本数とテーマの組み合わせが異なるため、Round 3 の値を他の版と単純に比べることはできません。表層の文字列指標であり、批評の正しさやモデル一般の優劣を示すものではありません。
判定役としてのくせ
記事「AIのハルシネーション対策を測った」では、主張の正誤の採点と一次情報での裁定にも 3 社の AI を使いました(判定に使ったモデルは、書き手とは別の Codex〔GPT-5.6 Sol〕・Claude Sonnet/Opus 5.5・Gemini 3.7/3.8 Flash)。判定役としても、くせが見えました。
| くせ | 数値 |
|---|---|
| Codex(OpenAI)は例外に触れていない主張を「誤り」としやすい | 例外や特例に触れていない主張を「誤り」としやすい。1 社の AI だけが違う判定をした型は「Codex だけが誤り」が 46 件で最も多い(Gemini だけ 2 件、Claude だけ 4 件) |
| Claude(Anthropic)は確信度を「中」「低」とする割合が高い | 確信度を「中」「低」にした割合 17.1%(Codex 3.6%、Gemini 1.8%) |
| 自社のモデルに甘い可能性がある | 最終的に誤りと確定した主張を、採点で「正しい」としていた割合(同じ社のモデルの文章/他社の文章)。Gemini の判定役 34%(44 件中 15 件)/16%(31 件中 5 件)、Claude の判定役 22%(27 件中 6 件)/12%(58 件中 7 件)、Codex の判定役 0%(5 件中 0 件)/5%(80 件中 4 件)。誤りと確定した主張に限った、件数の少ない探索的な比較(記事「AIのハルシネーション対策を測った」の集計) |
利益相反について: この記事の集計と執筆には、Anthropic の AI である Claude を使っています。また、上の判定役のくせは、比べられる側と同じ会社の AI が判定した記録から出したものです。Claude に有利な書き方になっていないか、原稿は Claude 自身に加えて OpenAI(Codex)と Google(Gemini)の AI にも読ませました。3 社の指摘は、初版の下書きに計 41 件、この版に計 29 件ありました。Claude だけに好意的な形容(「丁寧に」「細かく」など)や、区間が重なる差を Claude のくせとして書いた箇所、Claude の注意点の書き漏らしなどを直しています。
この結果の限界。
- この条件で見えたくせです。 2026 年 10 月の版、日本語の制度・技術の解説、ウェブ検索なし、討論の指示文の中での傾向です。会話・創作・プログラミング・画像では、くせが違う可能性があります。
- 指示に対する反応も含まれます。 字数の守り方やクロスチェックの数は、DebateCross の指示文(字数の指定、クロスチェックの記法、最終評価の求め方)にどう応えたかの違いでもあります。指示が違えば、くせの出方も変わります。
- テーマの数が少ない。 各モデル 45 本ですが、異なるお題は 15 です。区間が重なる差(数字の書き込み、統合メモで名前を書いた割合の Claude と Gemini など)は、前半でくせとして扱っていません。
- 規則で数えた近似です。 留保の言い回しや「自分の回答であることに触れた」かどうかは、決めた語の一覧に当たったかで数えています。言い換えや、語の一覧にない書き方は数え漏れます。「断りの言葉を伴う割合」は、記録を見たあとに足した事後の指標です。
- 主役の記録は、公開前に替えました。 記事「正確性を比較」を最新 3 モデルで組み直したのに合わせ、同じ組み合わせの討論(10 月 15 日)を主役にしました。それまでの主役(「AIのハルシネーション対策を測った」の討論)の値も「別の組み合わせの討論でも同じか」に載せています。
- アプリではなく API の結果です。 ChatGPT や Gemini のアプリは、独自の指示や検索が加わるため、くせの出方が違う可能性があります。
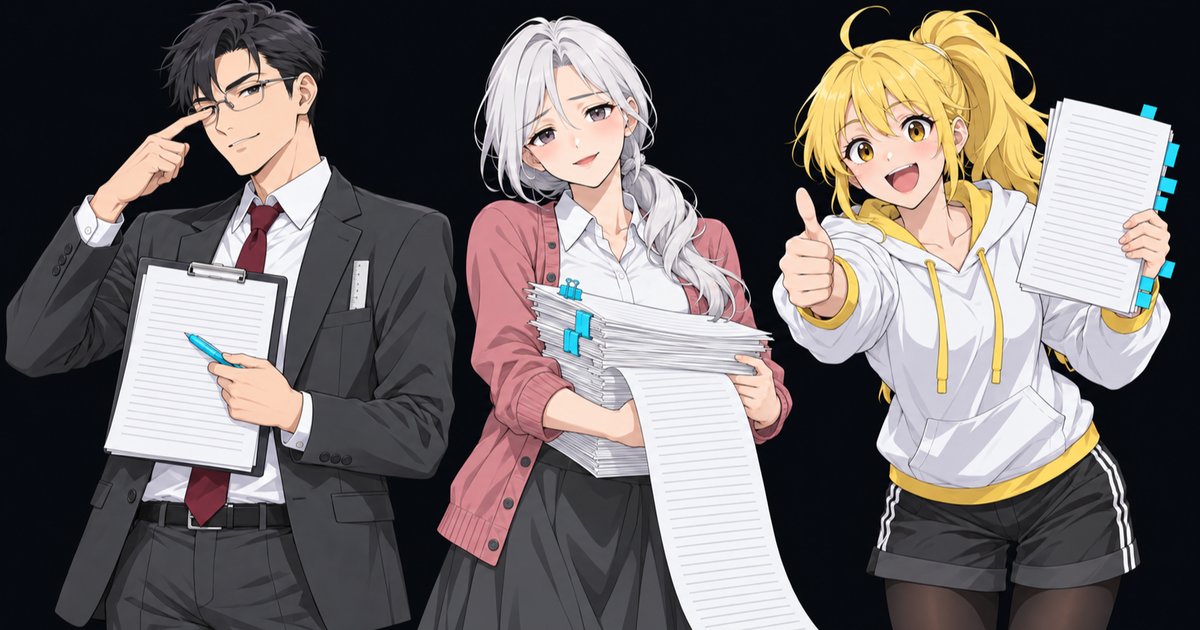
- 性格は比喩です。 「性格」「くせ」は、観察した書き方の傾向を分かりやすく言い表したもので、モデルに人格があるという意味ではありません。キャラクターの見た目は、その傾向を誇張して描いたものです。
- DebateCross の運営による記事です。 特定の AI 会社とは提携・広告の関係はありませんが、「複数の AI を組み合わせる」ことを勧める立場の運営が書いた記事です。
よくある質問。
Q. ChatGPT と Gemini の違いは何ですか。 A. この記事の条件(GPT-6.1 Sol と Gemini 4 Argon)では、GPT は指定の字数をほぼ守り(98%)、批評で事実の誤りを指摘する書式を使うことが最も多い一方、最終評価ではほぼ必ず自分の回答を選びました。Gemini は留保の言い回しが少なく言い切る書き方で、最も長く書き、誤りを指摘する書式の使用は少なめでした。最終評価では、選ばずに「同等」とすることもありました。
Q. Claude と Gemini の違いは何ですか。 A. どちらも指定字数を超えやすく、まとめ役では平均 2,000 字を超える長さでまとめます。Claude は批評で箇条書きを多く使い(1 本あたり約 60 行。Gemini は約 29 行)、相手を位置だけで呼ぶことが多い一方、Gemini は留保の少ない言い切る書き方で、補足メモをより厚く残しました(最終回答の 45%。Claude は 33%)。どの AI の意見かを補足メモに書く割合(Claude 67%、Gemini 40%)は、この規模でははっきりした差ではありません。
Q. 結局、どの AI がいちばんいいですか。 A. くせが違うので、目的によります。字数や形式を守らせたいなら GPT、指摘を箇条書きで多く挙げてほしいなら Claude、留保の少ない文面と採否の理由の厚いメモがほしいなら Gemini が合いそうです。どの AI にも気をつける点があるので、前半の「どう使い分けるか」の表も見てください。正確さ(誤りの少なさ)の比較は「ChatGPT・Claude・Gemini の正確性を比較」にまとめています。
Q. アプリの ChatGPT・Claude・Gemini でも、同じくせがありますか。 A. この記事は API で同じ指示を渡した結果です。アプリは独自の指示や検索が加わるため、同じとは限りません。ただし、字数の守り方や留保の付け方のような書き方のくせは、使っていて感じる違いの手がかりになります。
Q. なぜ GPT は、自分の回答をほぼ毎回選ぶのですか。 A. 理由はこの記録からは分かりません。批評の指示は「最も優れていると思う回答を 1 つ選ぶ(選びきれなければ「同等」と書く)」ことを求めており、GPT はほぼ毎回、自分の回答を選んだ、という観察です。参考の Sol Pro 版と Sol 版でも、93〜98% でした。追加した Terra 版では、Terra が自分の回答を選んだ割合は 63%(95% 区間 43〜81%)でした。Terra 版は完了 43 討論に限る参考集計で、GPT 全般の傾向としては言い切れません。
Q. 安い Gemini 3.8 Flash でも、くせは同じですか。 A. 参考の 2 回の討論で確かめたところ、言い切る書き方、クロスチェックの少なさ、統合メモの厚さは同じでした。違ったのは、Flash は「同等」とせず、長く書く傾向も Argon ほどはっきりしなかったことです。Flash の批評では、良い点の節を厚く書く傾向もありました。
Q. キャラクターは各社の公式ですか。 A. いいえ。DebateCross が、この記事の観察をもとに描いたオリジナルのキャラクターです。各社のロゴやブランドカラーは使っていません。
Q. この記事は更新されますか。 A. 各社のモデルの版が変わったら、同じお題・同じ手順で測り直し、更新日と結果を書き換える予定です。
自分のお題で、くせを確かめる。
同じお題を 3 つの AI に書かせ、互いに批評させると、書き方や批評のくせの違いを自分の目で確かめられます。新規登録で 250 円分のボーナス(カード登録不要・有効期限 30 日)。月額料金はかかりません。
更新履歴: 2026 年 11 月 2 日 GPT-6.1 Terra 版の参考表(完了 43 討論・4 指標)と、統合役・欠けた討論・実行順の注記を追加/2026 年 10 月 27 日 GPT-6.1 Terra(10 月 27 日提供開始)の記述を追加(比べたモデル・数値は変えていません)/2026 年 10 月 16 日 初版(15 テーマ × 各 3 回、GPT-6.1 Sol/Claude Sonnet 5.5/Gemini 4 Argon。参考に GPT-6.1 Sol Pro・Gemini 3.8 Flash を含む討論)
ChatGPT・GPT は OpenAI の、Claude は Anthropic の、Gemini は Google の商標または登録商標です。キャラクターは DebateCross が実験の観察をもとに描いたもので、各社の公式キャラクターではありません。
出典
確認日は 2026-10-15 です。ただし、GPT-6.1 Terra の提供開始と単価は 2026-10-27 に確かめました。
- 討論の記録と集計は、検証データ一式で公開
- 各モデルの料金: OpenRouter のモデル一覧(2026-10-14 確認。GPT-6.1 Terra の単価は 2026-10-27 確認、掲載日は 2026-10-26〔UTC。日本時間 10 月 27 日〕)